Machine Learning para Trading: Testamos Random Forest no Bybit
Machine learning para trading é um assunto que já rendeu dezenas de vídeos técnicos e discussões sérias em inglês sobre trading algorítmico com IA - e quase nenhum conteúdo equivalente em português. Resolvemos testar machine learning para trading na prática: pegamos os mesmos dados que já usamos nos outros backtests do site e deixamos um modelo de machine learning random forest decidir sozinho quando entrar numa operação, em vez de seguir uma regra fixa como RSI ou MACD.
Nos outros backtests da nossa série, quem define a regra de entrada somos nós. Aqui, demos ao modelo 10 indicadores diferentes ao mesmo tempo e deixamos ele encontrar sozinho a combinação que funciona - sem escrever uma única condição fixa. O resultado abaixo é honesto, incluindo os motivos para não confiar cegamente nele.
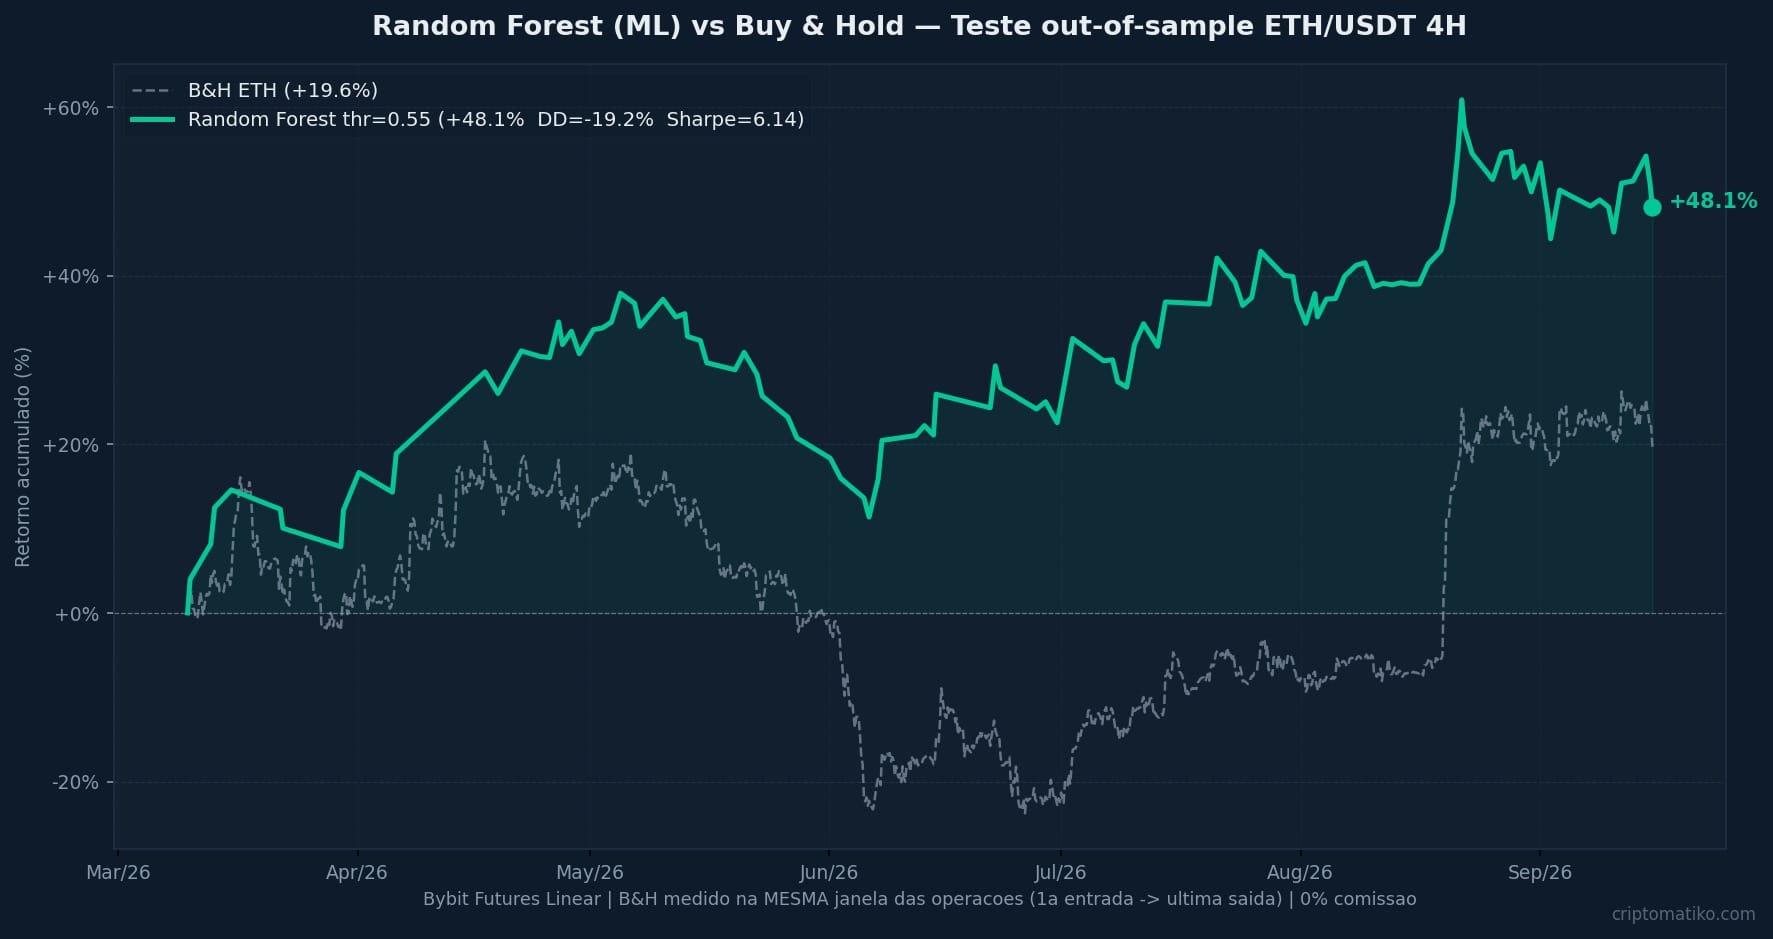
Resumo rápido: testamos se machine learning para trading supera uma regra fixa. Este backtest random forest treinou um modelo com 10 indicadores técnicos como features, em dados reais de ETH/USDT na Bybit, e comparou contra o Buy & Hold no mesmo período de teste.
| Limiar | Trades | Win Rate | Retorno | Drawdown | Buy & Hold |
|---|---|---|---|---|---|
| 0,55 (destacado) | 116 | 50,9% | +48,1% | -19,2% | +19,6% |
Bybit Futures Linear, ETH/USDT 4H, split cronológico 70/30, teste 100% out-of-sample, B&H medido na mesma janela das operações, 0% comissão.
⚠️ Aviso de risco: Trading de criptomoedas envolve risco real de perda de capital. Resultados passados não garantem resultados futuros. Este conteúdo é educacional e não constitui conselho financeiro ou de investimento.
Uma nota de vocabulário antes de continuar: quando falamos em random forest trading ao longo deste texto, estamos nos referindo especificamente a este experimento. Inteligência artificial trading, de forma mais ampla, inclui qualquer abordagem baseada em modelos estatísticos - não só Random Forest. E boa parte da comunidade internacional já chama esse campo inteiro de trading algorítmico com IA, o mesmo termo que usamos por aqui.
O que muda quando é a IA que decide, não uma regra fixa
Nos outros backtests do site, a regra de entrada é sempre explícita: "RSI cruzou abaixo de 30", "MACD cruzou acima do sinal e o preço está acima da EMA200". Um humano define a condição, e o computador só executa. Isso é trading algorítmico na sua forma mais simples - regras fixas, sem ambiguidade.
Machine learning para trading inverte essa lógica. Em vez de definir uma regra única, damos ao modelo vários indicadores ao mesmo tempo - RSI, MACD, distância das médias móveis, largura das Bollinger Bands, volume - e deixamos que ele encontre sozinho a combinação que melhor separa "sobe" de "desce". O modelo não segue uma fórmula que escrevemos; ele aprende um padrão a partir dos próprios dados.
O que é machine learning aplicado ao trading?
É o uso de um algoritmo que aprende a combinar múltiplos indicadores técnicos a partir de dados históricos, em vez de seguir uma regra única definida manualmente. O modelo produz uma probabilidade de alta ou baixa, e essa probabilidade vira o sinal de entrada.
A vantagem teórica é clara: um modelo de inteligência artificial trading pode captar interações entre indicadores que uma regra simples nunca vai enxergar - por exemplo, "RSI baixo só importa quando a volatilidade também está baixa". A desvantagem, que vamos detalhar mais adiante, é que essa mesma flexibilidade é também o maior risco: quanto mais o modelo pode se ajustar aos dados, mais fácil é ele se ajustar ao ruído em vez de a um padrão real.
Como fizemos o backtest de machine learning para trading
Este backtest random forest usou velas de 4 horas de ETH/USDT na Bybit Futures, cerca de 4.000 candles - o mesmo par e a mesma exchange dos outros backtests da nossa série. Cada vela ganhou 10 features numéricas: RSI(14), as três linhas do MACD(12,26,9), a distância normalizada até as EMAs de 20, 50 e 200 períodos, o %B e a largura das Bollinger Bands, e o volume relativo à média de 20 períodos.
O label que o modelo tenta prever é binário: o preço fecha mais alto daqui a 6 velas (24 horas) do que fecha agora? Treinamos um RandomForestClassifier com 300 árvores e profundidade máxima de 5 - parâmetros conservadores, pensados para reduzir a chance do modelo decorar o ruído dos dados de treino em vez de aprender um padrão real.
O ponto mais importante da metodologia é o split dos dados: 70% mais antigos para treino, 30% mais recentes para teste, sem embaralhar nada. O modelo nunca vê um único candle do período de teste durante o treino - a mesma disciplina que já explicamos em detalhe no nosso artigo sobre as armadilhas mais comuns de um backtest em Python. Embaralhar dados de série temporal antes de treinar um modelo é o erro mais comum - e mais fácil de não perceber - em qualquer teste de machine learning para trading.
Para simular a operação real, cada sinal (probabilidade acima de um limiar) vira uma entrada comprada no open da vela seguinte, com stop loss fixo de 2%, take profit de 2R e saída forçada após 6 velas se nenhum dos dois bater antes. Risco fixo por operação, nunca capital total - a mesma regra de sizing que aplicamos em todos os backtests do site, porque comprometer 100% do capital a cada entrada distorce qualquer resultado com mais de algumas dezenas de trades.
💡 Dica do Autor: decidi propositalmente não modelar comissão nesta primeira rodada de testes com machine learning para trading. Não foi descuido - foi uma escolha para isolar uma pergunta de cada vez: primeiro, "esse modelo encontra algum padrão real?" Depois, com a resposta em mãos, "esse padrão sobrevive aos custos reais de operar?" Misturar as duas perguntas no mesmo teste dificulta saber qual delas está errada quando o resultado não bate.
Todo o código está em Python, usando a biblioteca padrão da linguagem mais pandas, numpy e scikit-learn - as mesmas ferramentas que já usamos nos outros backtests de trading algorítmico com IA da série.
Resultado: o modelo de machine learning para trading bateu o Buy & Hold?
Este experimento de machine learning random forest testou quatro limiares de probabilidade diferentes para decidir quando um sinal vira uma entrada. Quanto mais alto o limiar, menos operações o modelo aceita - mas as que aceita tendem a ter mais confiança.
| Limiar | Trades | Win Rate | Retorno | Sharpe | Drawdown |
|---|---|---|---|---|---|
| 0,50 | 149 | 50,3% | +43,2% | 4,64 | -28,0% |
| 0,55 | 116 | 50,9% | +48,1% | 6,14 | -19,2% |
| 0,60 | 60 | 58,3% | +37,7% | 9,47 | -13,6% |
| 0,65 | 13 | 69,2% | +11,8% | 16,48 | -2,0% |
Destacamos o limiar 0,55 e não o de 0,65 - que tem o Sharpe mais alto da tabela. O motivo é estatístico, não uma escolha para deixar o gráfico mais bonito: 13 operações são poucas demais para confiar no resultado. Poderia ser sorte. Já 116 operações no limiar 0,55 dão uma base mais sólida para dizer que o modelo encontrou algo, mesmo que o retorno bruto seja menor que o do limiar mais restritivo. É a curva verde que você já viu no gráfico no início do artigo.
O que é um Random Forest?
É um modelo de machine learning que combina centenas de árvores de decisão treinadas com pequenas variações dos mesmos dados, e usa a média das previsões de todas elas. Isso reduz o risco de qualquer árvore individual decorar ruído específico dos dados de treino.
Depois de treinado, o modelo também revela quais das 10 features mais pesaram na decisão - o que chamamos de importância de cada feature. No nosso teste, a largura das Bollinger Bands (uma medida de volatilidade) foi a mais relevante, seguida da distância até a EMA de 200 períodos e das três variáveis do MACD.
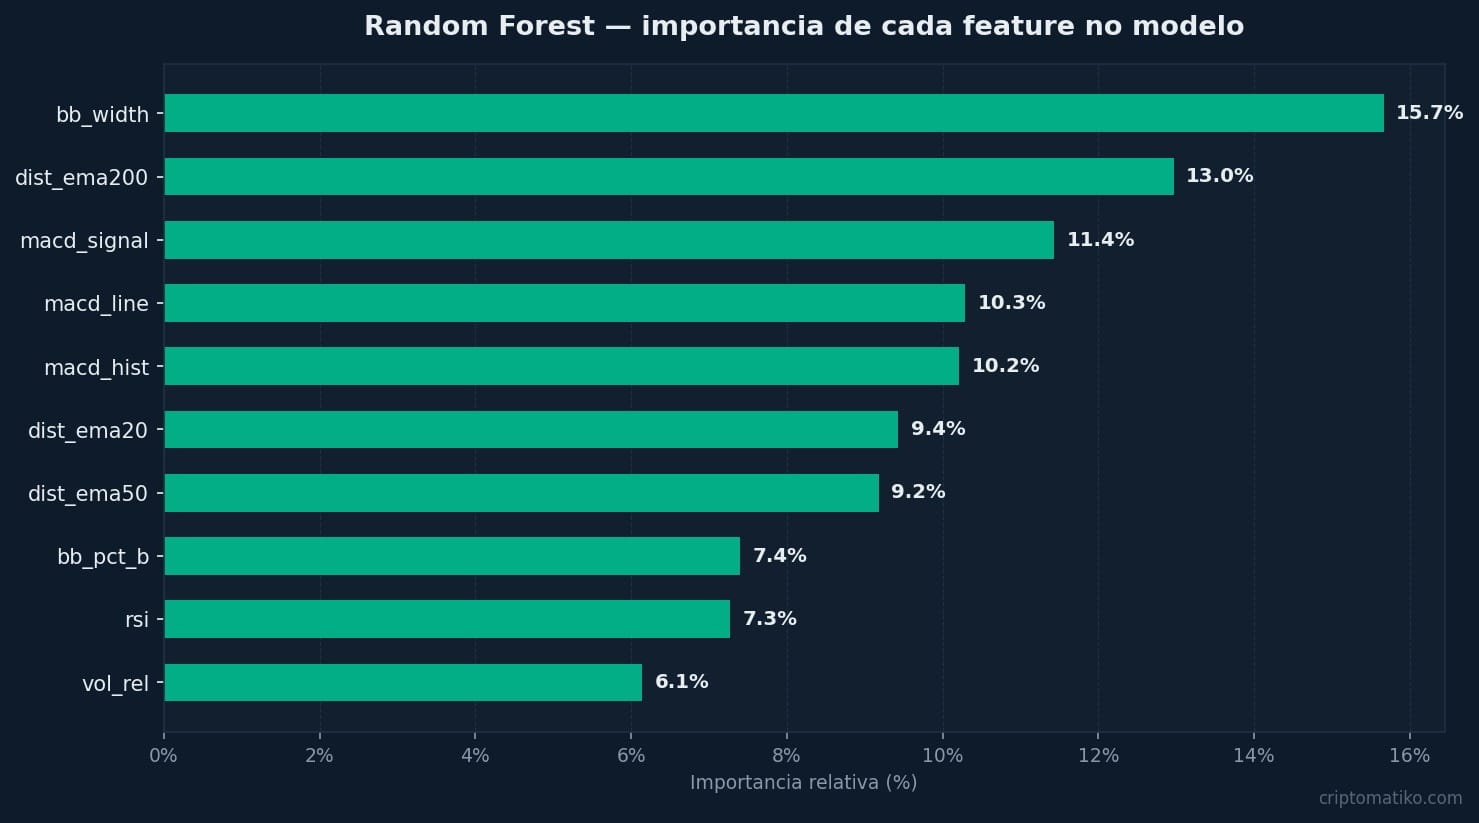
Isso é um dado interessante por si só: o modelo não deu peso desproporcional a nenhum indicador isolado. Ele distribuiu a decisão entre volatilidade, tendência e momentum - o tipo de combinação que seria trabalhoso reproduzir manualmente numa regra fixa, e um bom exemplo do que a onda de trading algorítmico com IA promete entregar.
Os limites reais desse experimento com machine learning para trading
Um resultado positivo logo na primeira tentativa de machine learning random forest é, paradoxalmente, motivo para desconfiar - não para comemorar. Antes de qualquer leitor considerar isso uma "estratégia pronta", vale listar exatamente onde esse backtest random forest ainda é frágil.
Um único ativo, uma única janela de tempo. Testamos só ETH/USDT, num período de teste de pouco mais de 6 meses. Não sabemos se o mesmo random forest trading, treinado do zero, encontraria um padrão parecido em BTC ou SOL, ou numa janela de tempo diferente. Sem isso, não dá para separar "o modelo encontrou um padrão real" de "o modelo teve sorte nesse recorte específico".
Sem reentrenamento walk-forward. Treinamos o modelo uma única vez, nos primeiros 70% dos dados, e testamos no restante. Isso é correto para medir se o modelo generaliza - mas um modelo em produção precisaria de uma rotina de retreino periódico, porque o comportamento do mercado muda com o tempo. Diferente de uma regra fixa como a que usamos no backtest de divergência RSI, que continua igual para sempre, este modelo "aprendeu" um contexto de mercado específico que pode deixar de valer.
Comissão não modelada. Como já expliquei, essa decisão foi proposital nesta rodada - mas é uma limitação real. Com 116 operações no período de teste, os custos reais de operar (taxa da corretora, spread, slippage) consomem uma fatia do retorno que este teste não mostra.
Isso não é um bot que executa ordens. Este experimento de inteligência artificial trading é o motor de sinal e o backtest - não uma automação pronta para rodar com dinheiro real. Transformar isso em algo que opera de verdade exigiria salvar o modelo treinado, recalcular as features em tempo real de forma idêntica ao backtest random forest, e integrar com a API de uma exchange - um projeto bem maior do que este teste.
Conclusão: vale a pena confiar em machine learning para trading?
Nesse recorte específico - ETH/USDT, 4H, os últimos 6 meses de teste - o modelo de machine learning random forest superou o Buy & Hold: +48,1% contra +19,6%, com menos drawdown. É um resultado real, não inventado. Mas, pelos motivos que listamos acima, ainda não é um resultado validado o suficiente para arriscar capital de verdade.
O código completo deste backtest random forest está disponível no GitHub para quem quiser reproduzir o teste, rodar em outro ativo ou testar outra janela de tempo - exatamente o próximo passo que qualquer experimento sério de random forest trading pede antes de qualquer conclusão mais forte.
Na minha experiência com os outros backtests da série, o padrão se repete quando o assunto é machine learning para trading: o primeiro resultado nunca é a palavra final. É o ponto de partida para testar se o que parece funcionar continua funcionando fora do cenário exato onde foi descoberto - a mesma cautela que qualquer conteúdo sério de trading algorítmico com IA deveria ter.
Perguntas Frequentes sobre Machine Learning para Trading
As perguntas mais comuns de quem está considerando testar isso no próprio par ou estratégia:
Machine learning para trading é melhor que indicadores técnicos tradicionais?
Não necessariamente. Neste teste, o modelo de machine learning random forest superou o Buy & Hold num único ativo e período - mas isso não prova que machine learning para trading supera regras fixas de forma geral. Cada abordagem tem riscos próprios: uma regra fixa é simples demais para captar interações complexas; um modelo de inteligência artificial trading pode se ajustar ao ruído em vez de a um padrão real (overfitting).
Preciso saber programar para usar machine learning no trading?
Sim, neste caso. Todo experimento de random forest trading como este foi construído inteiramente em Python, com bibliotecas como pandas e scikit-learn. O código está aberto no GitHub para quem já sabe programar reproduzir ou adaptar - não é uma ferramenta pronta de configurar sem código.
Random forest para trading tem risco de overfitting?
Sim, e é o maior risco de qualquer modelo de inteligência artificial trading aplicado a séries temporais financeiras. Usamos profundidade máxima limitada (5) e split cronológico sem embaralhar dados justamente para reduzir esse risco em qualquer random forest trading - mas testar em um único ativo e período, como fizemos aqui, não elimina a possibilidade de o resultado ser específico demais desse recorte.
⚠️ Aviso de risco: Trading de criptomoedas envolve risco real de perda de capital. Resultados passados não garantem resultados futuros. Este conteúdo é educacional e não constitui conselho financeiro ou de investimento.
Alguns links neste artigo são de afiliados, com bônus exclusivos para você. Como isso funciona?