Machine Learning para Trading: Testeamos Random Forest en Bybit
Machine learning para trading es un tema que ya generó decenas de videos técnicos y discusiones serias en inglés sobre trading algorítmico con IA - y casi ningún contenido equivalente en español.
Nos propusimos testear machine learning para trading en la práctica: usamos los mismos datos que ya usamos en los otros backtests del sitio y dejamos que un modelo de machine learning random forest decida solo cuándo entrar en una operación, en vez de seguir una regla fija como el RSI o el MACD.
En los otros backtests de nuestra serie, la regla de entrada la definimos nosotros. Acá, le dimos al modelo 10 indicadores distintos al mismo tiempo y dejamos que encuentre solo la combinación que funciona - sin escribir una sola condición fija.
El resultado de abajo es honesto, incluidos los motivos para no confiar ciegamente en él.
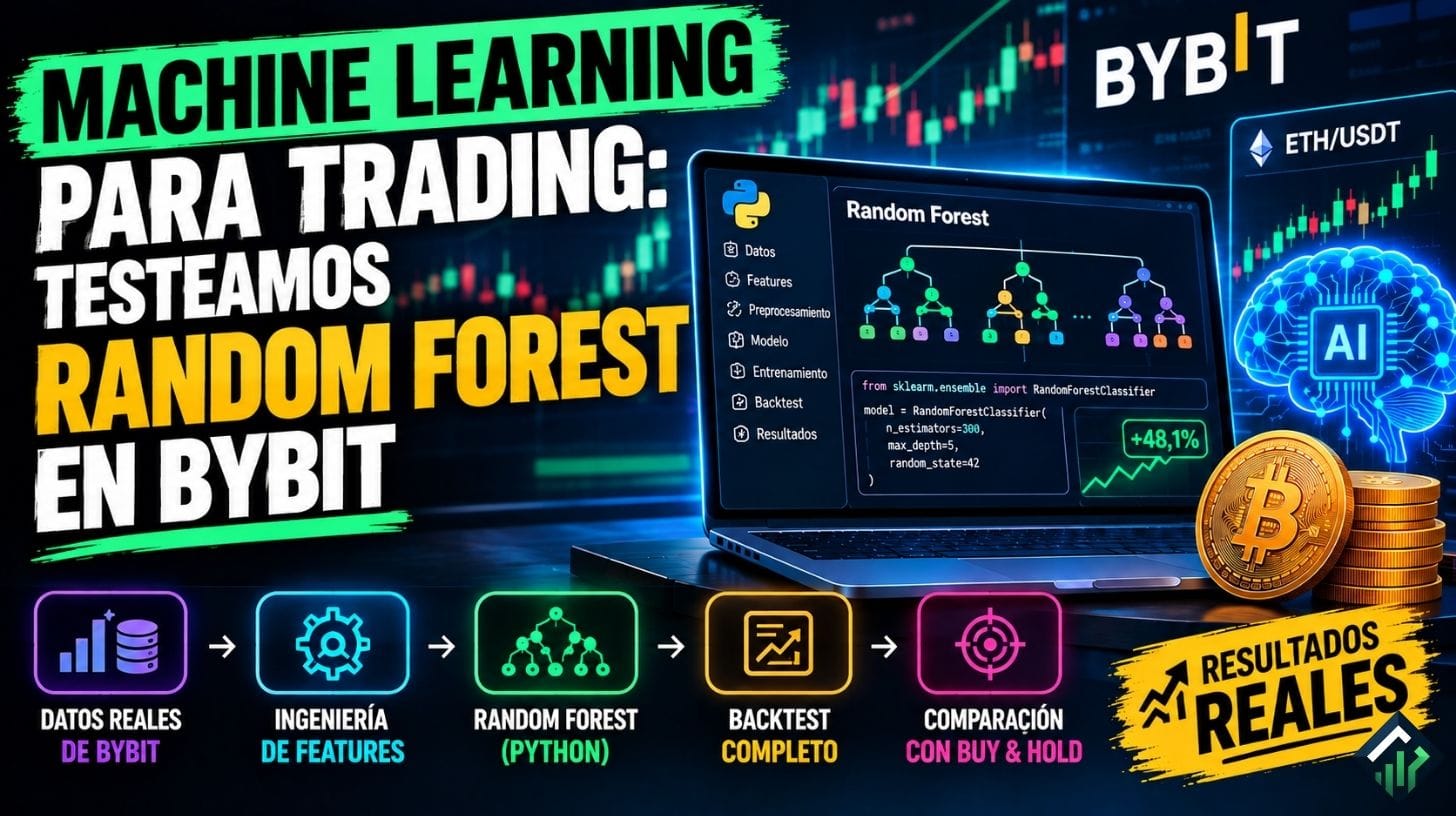
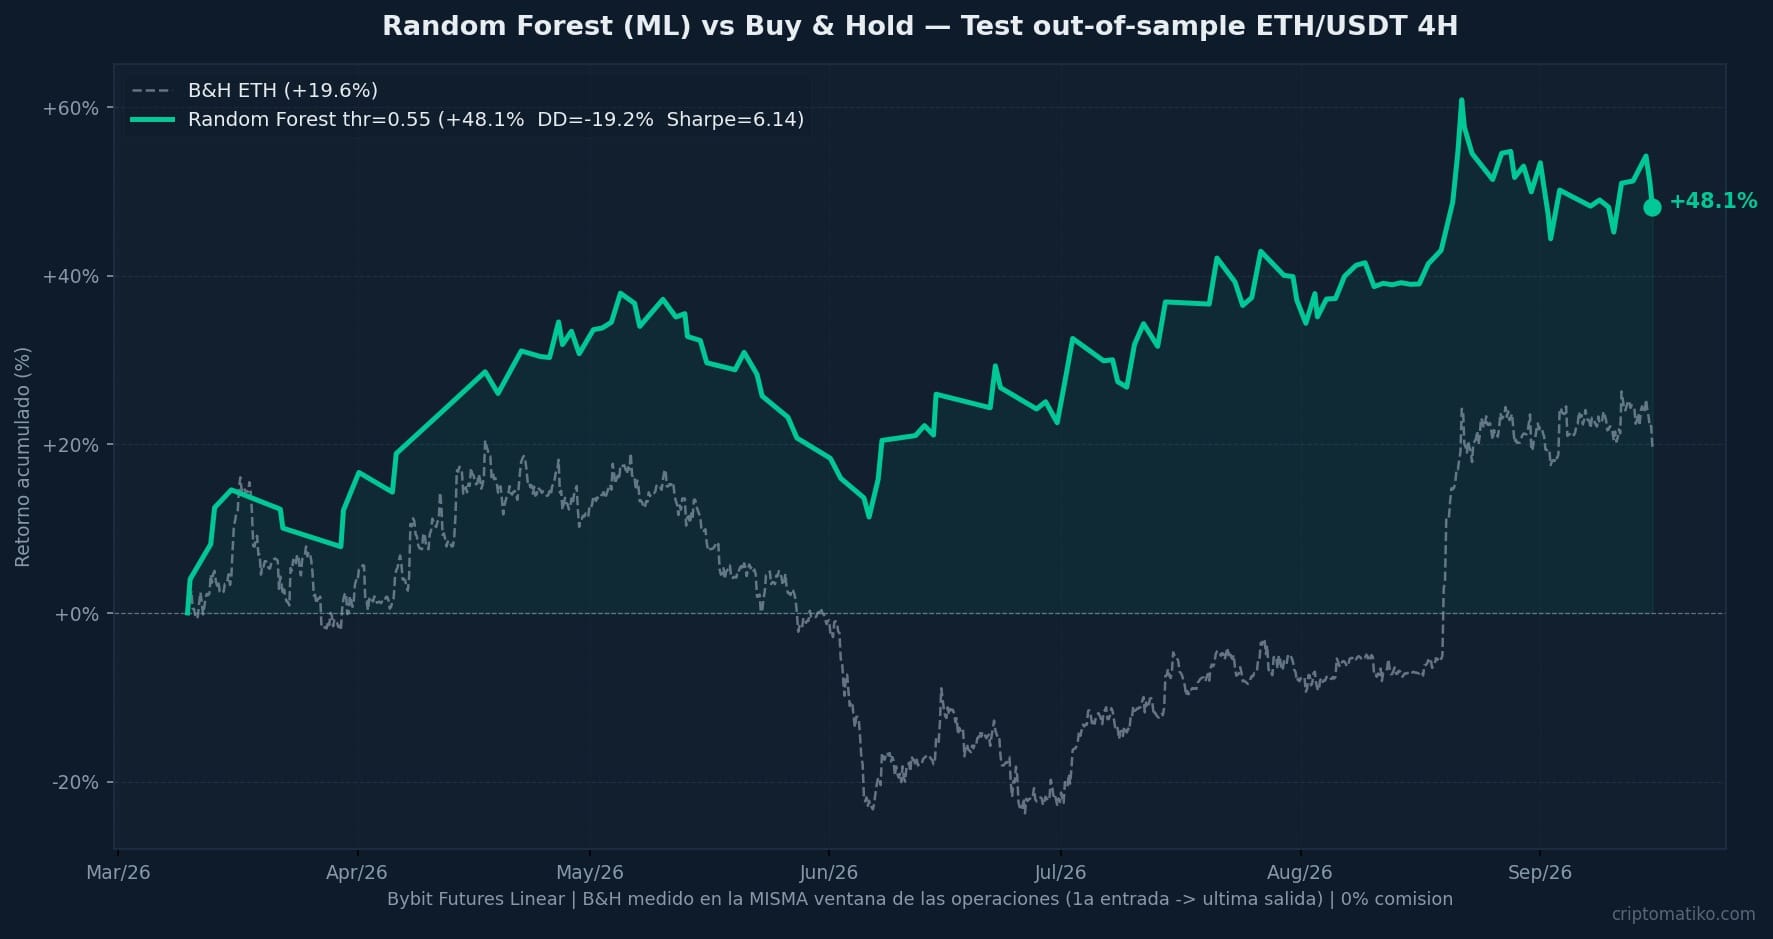
Resumen rápido: testeamos si machine learning para trading supera una regla fija. Este backtest random forest entrenó un modelo con 10 indicadores técnicos como features, con datos reales de ETH/USDT en Bybit, y lo comparó contra el Buy & Hold en el mismo período de test.
| Umbral | Trades | Win Rate | Retorno | Drawdown | Buy & Hold |
|---|---|---|---|---|---|
| 0,55 (destacado) | 116 | 50,9% | +48,1% | -19,2% | +19,6% |
Bybit Futures Linear, ETH/USDT 4H, split cronológico 70/30, test 100% out-of-sample, B&H medido en la misma ventana de las operaciones, 0% comisión.
⚠️ Aviso de riesgo: El trading de criptomonedas implica riesgo real de pérdida de capital. Los resultados pasados no garantizan resultados futuros. Este contenido es educativo y no constituye asesoramiento financiero ni de inversión.
Una nota de vocabulario antes de seguir: cuando hablamos de random forest trading a lo largo de este texto, nos referimos específicamente a este experimento.
Inteligencia artificial trading, en un sentido más amplio, incluye cualquier enfoque basado en modelos estadísticos - no solo Random Forest. Y buena parte de la comunidad internacional ya llama a todo este campo trading algorítmico con IA, el mismo término que usamos acá.
Qué cambia cuando es la IA la que decide, no una regla fija
En los otros backtests del sitio, la regla de entrada siempre es explícita: "el RSI cruzó por debajo de 30", "el MACD cruzó por arriba de la señal y el precio está por encima de la EMA200".
Un humano define la condición, y la computadora solo ejecuta. Eso es trading algorítmico en su forma más simple - reglas fijas, sin ambigüedad.
Machine learning para trading invierte esa lógica. En vez de definir una regla única, le damos al modelo varios indicadores al mismo tiempo - RSI, MACD, distancia de las medias móviles, ancho de las Bollinger Bands, volumen - y dejamos que encuentre solo la combinación que mejor separa "sube" de "baja".
El modelo no sigue una fórmula que escribimos nosotros; aprende un patrón a partir de los propios datos.
¿Qué es el machine learning aplicado al trading?
Es el uso de un algoritmo que aprende a combinar múltiples indicadores técnicos a partir de datos históricos, en vez de seguir una regla única definida manualmente. El modelo produce una probabilidad de suba o baja, y esa probabilidad se convierte en la señal de entrada.
La ventaja teórica es clara: un modelo de inteligencia artificial trading puede captar interacciones entre indicadores que una regla simple nunca va a detectar - por ejemplo, "RSI bajo solo importa cuando la volatilidad también está baja".
La desventaja, que vamos a detallar más adelante, es que esa misma flexibilidad es también el mayor riesgo: cuanto más se puede ajustar el modelo a los datos, más fácil es que se ajuste al ruido en vez de a un patrón real.
Cómo hicimos el backtest de machine learning para trading
Este backtest random forest usó velas de 4 horas de ETH/USDT en Bybit Futures, unas 4.000 velas - el mismo par y la misma exchange que los otros backtests de nuestra serie.
Cada vela sumó 10 features numéricas: RSI(14), las tres líneas del MACD(12,26,9), la distancia normalizada a las EMAs de 20, 50 y 200 períodos, el %B y el ancho de las Bollinger Bands, y el volumen relativo al promedio de 20 períodos.
El label que el modelo intenta predecir es binario: ¿el precio cierra más alto dentro de 6 velas (24 horas) que ahora? Entrenamos un RandomForestClassifier con 300 árboles y profundidad máxima de 5 - parámetros conservadores, pensados para reducir la chance de que el modelo memorice el ruido de los datos de entrenamiento en vez de aprender un patrón real.
El punto más importante de la metodología es el split de los datos: 70% más antiguo para entrenamiento, 30% más reciente para test, sin mezclar nada.
El modelo nunca ve una sola vela del período de test durante el entrenamiento - la misma disciplina que ya explicamos en detalle en nuestro artículo sobre las trampas más comunes de un backtest en Python.
Mezclar datos de series temporales antes de entrenar un modelo es el error más común - y más fácil de no notar - en cualquier test de machine learning para trading.
Para simular la operación real, cada señal (probabilidad por encima de un umbral) se convierte en una entrada comprada en la apertura de la vela siguiente, con stop loss fijo de 2%, take profit de 2R y salida forzada después de 6 velas si ninguno de los dos se activó antes.
Riesgo fijo por operación, nunca capital total - la misma regla de sizing que aplicamos en todos los backtests del sitio, porque comprometer el 100% del capital en cada entrada distorsiona cualquier resultado con más de algunas decenas de operaciones.
💡 Consejo Sano: decidí a propósito no modelar comisión en esta primera tanda de tests con machine learning para trading. No fue un descuido - fue una decisión para aislar una pregunta a la vez: primero, "¿este modelo encuentra algún patrón real?" Después, con la respuesta en mano, "¿ese patrón sobrevive a los costos reales de operar?" Mezclar las dos preguntas en el mismo test dificulta saber cuál de las dos está fallando cuando el resultado no cierra.
Todo el código está en Python, usando la biblioteca estándar del lenguaje más pandas, numpy y scikit-learn - las mismas herramientas que ya usamos en los otros backtests de trading algorítmico con IA de la serie.
Resultado: ¿el modelo de machine learning para trading le ganó al Buy & Hold?
Este experimento de machine learning random forest testeó cuatro umbrales de probabilidad distintos para decidir cuándo una señal se convierte en una entrada. Cuanto más alto el umbral, menos operaciones acepta el modelo - pero las que acepta tienden a tener más confianza.
| Umbral | Trades | Win Rate | Retorno | Sharpe | Drawdown |
|---|---|---|---|---|---|
| 0,50 | 149 | 50,3% | +43,2% | 4,64 | -28,0% |
| 0,55 | 116 | 50,9% | +48,1% | 6,14 | -19,2% |
| 0,60 | 60 | 58,3% | +37,7% | 9,47 | -13,6% |
| 0,65 | 13 | 69,2% | +11,8% | 16,48 | -2,0% |
Destacamos el umbral 0,55 y no el de 0,65 - que tiene el Sharpe más alto de la tabla. El motivo es estadístico, no una elección para que el gráfico se vea mejor: 13 operaciones son muy pocas para confiar en el resultado. Podría ser suerte.
En cambio, 116 operaciones en el umbral 0,55 dan una base más sólida para decir que el modelo encontró algo, aunque el retorno bruto sea menor que el del umbral más restrictivo. Es la curva verde que ya viste en el gráfico al principio del artículo.
¿Qué es un Random Forest?
Es un modelo de machine learning que combina cientos de árboles de decisión entrenados con pequeñas variaciones de los mismos datos, y usa el promedio de las predicciones de todos ellos. Esto reduce el riesgo de que un árbol individual memorice ruido específico de los datos de entrenamiento.
Una vez entrenado, el modelo también revela cuáles de las 10 features pesaron más en la decisión - lo que llamamos importancia de cada feature.
En nuestro test, el ancho de las Bollinger Bands (una medida de volatilidad) fue la más relevante, seguida de la distancia a la EMA de 200 períodos y de las tres variables del MACD.
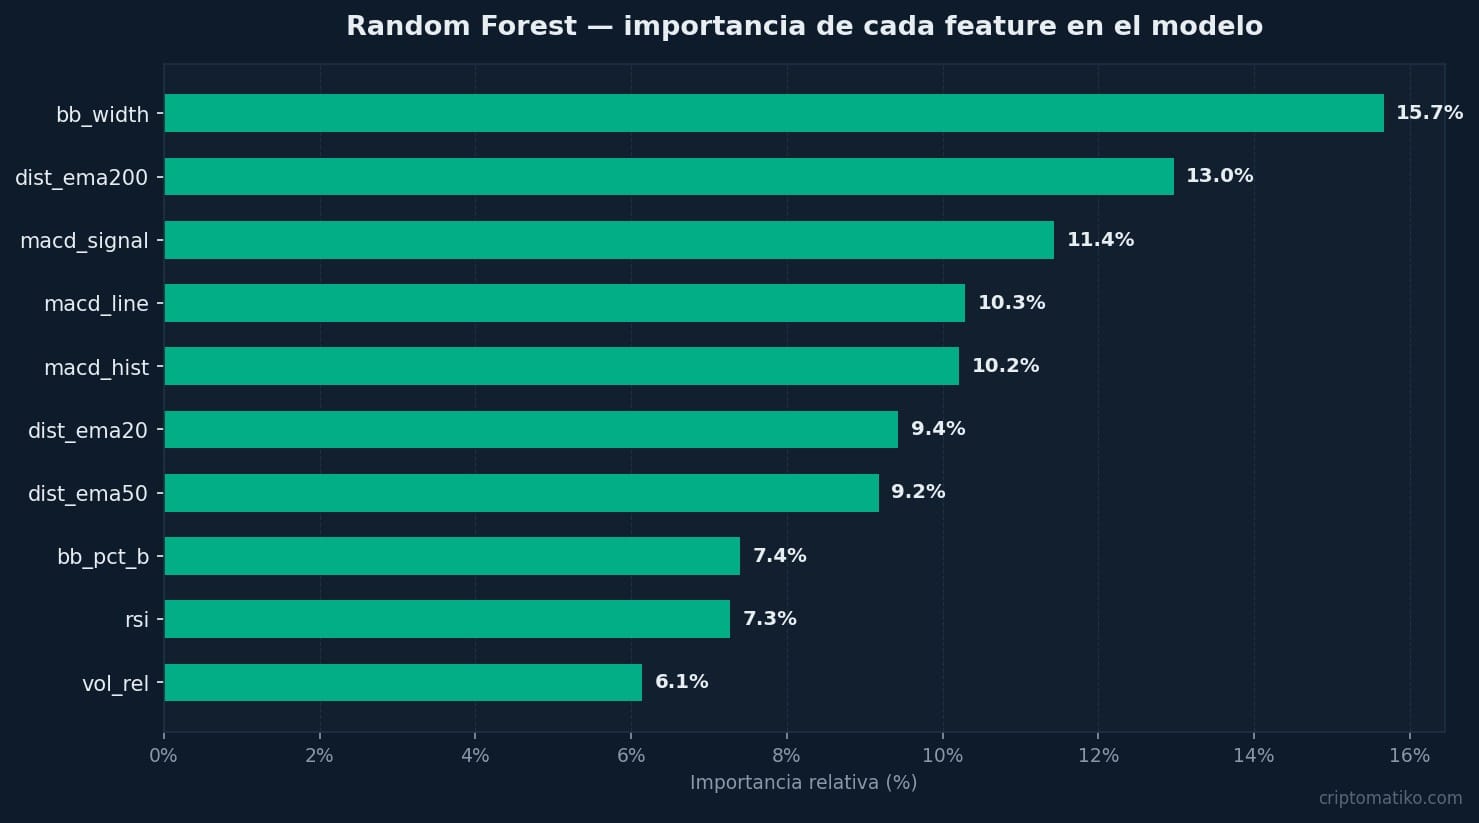
Esto es un dato interesante en sí mismo: el modelo no le dio un peso desproporcionado a ningún indicador aislado.
Distribuyó la decisión entre volatilidad, tendencia y momentum - el tipo de combinación que sería trabajoso reproducir a mano en una regla fija, y un buen ejemplo de lo que promete la ola de trading algorítmico con IA.
Los límites reales de este experimento con machine learning para trading
Un resultado positivo en el primer intento de machine learning random forest es, paradójicamente, motivo de desconfianza - no de festejo.
Antes de que cualquier lector considere esto una "estrategia lista", vale la pena listar exactamente dónde este backtest random forest todavía es frágil.
Un solo activo, una sola ventana de tiempo. Testeamos solo ETH/USDT, en un período de test de poco más de 6 meses.
No sabemos si el mismo random forest trading, entrenado de cero, encontraría un patrón parecido en BTC o SOL, o en una ventana de tiempo distinta. Sin eso, no se puede separar "el modelo encontró un patrón real" de "el modelo tuvo suerte en este recorte específico".
Sin reentrenamiento walk-forward. Entrenamos el modelo una sola vez, en el primer 70% de los datos, y lo testeamos en el resto.
Eso es correcto para medir si el modelo generaliza - pero un modelo en producción necesitaría una rutina de reentrenamiento periódico, porque el comportamiento del mercado cambia con el tiempo.
A diferencia de una regla fija como la que usamos en el backtest de divergencia RSI, que se mantiene igual para siempre, este modelo "aprendió" un contexto de mercado específico que puede dejar de valer.
Comisión no modelada. Como ya expliqué, esa decisión fue a propósito en esta tanda - pero es una limitación real. Con 116 operaciones en el período de test, los costos reales de operar (comisión de la exchange, spread, slippage) consumen una parte del retorno que este test no muestra.
Esto no es un bot que ejecuta órdenes. Este experimento de inteligencia artificial trading es el motor de señal y el backtest - no una automatización lista para correr con dinero real.
Convertir esto en algo que opere de verdad requeriría guardar el modelo entrenado, recalcular las features en tiempo real de forma idéntica al backtest random forest, e integrarlo con la API de una exchange - un proyecto bastante más grande que este test.
Conclusión: ¿vale la pena confiar en machine learning para trading?
En este recorte específico - ETH/USDT, 4H, los últimos 6 meses de test - el modelo de machine learning random forest le ganó al Buy & Hold: +48,1% contra +19,6%, con menos drawdown.
Es un resultado real, no inventado. Pero, por los motivos que listamos arriba, todavía no es un resultado validado lo suficiente como para arriesgar capital de verdad.
El código completo de este backtest random forest está disponible en GitHub para quien quiera reproducir el test, correrlo en otro activo o testear otra ventana de tiempo - exactamente el próximo paso que le pide cualquier experimento serio de random forest trading antes de una conclusión más fuerte.
En mi experiencia con los otros backtests de la serie, el patrón se repite cuando el tema es machine learning para trading: el primer resultado nunca es la palabra final.
Es el punto de partida para testear si lo que parece funcionar sigue funcionando fuera del escenario exacto donde se descubrió - la misma cautela que debería tener cualquier contenido serio de trading algorítmico con IA.
Preguntas Frecuentes sobre Machine Learning para Trading
Las preguntas más comunes de quien está considerando testear esto en su propio par o estrategia.
¿Machine learning para trading es mejor que los indicadores técnicos tradicionales?
No necesariamente. En este test, el modelo de machine learning random forest le ganó al Buy & Hold en un solo activo y período - pero eso no prueba que machine learning para trading supere a las reglas fijas en general.
Cada enfoque tiene sus propios riesgos: una regla fija es demasiado simple para captar interacciones complejas; un modelo de inteligencia artificial trading puede ajustarse al ruido en vez de a un patrón real (overfitting).
¿Necesito saber programar para usar machine learning en el trading?
Sí, en este caso. Todo experimento de random forest trading como este se construyó enteramente en Python, con bibliotecas como pandas y scikit-learn.
El código está abierto en GitHub para quien ya sepa programar y quiera reproducirlo o adaptarlo - no es una herramienta lista para configurar sin código.
¿Random forest para trading tiene riesgo de overfitting?
Sí, y es el mayor riesgo de cualquier modelo de inteligencia artificial trading aplicado a series temporales financieras.
Usamos profundidad máxima limitada (5) y split cronológico sin mezclar datos justamente para reducir ese riesgo en cualquier random forest trading - pero testear en un solo activo y período, como hicimos acá, no elimina la posibilidad de que el resultado sea demasiado específico de este recorte.
⚠️ Aviso de riesgo: El trading de criptomonedas implica riesgo real de pérdida de capital. Los resultados pasados no garantizan resultados futuros. Este contenido es educativo y no constituye asesoramiento financiero ni de inversión.
Algunos links en este artículo son de afiliados, con bonos exclusivos para vos. ¿Cómo funciona?